Üretken yapay zekâ ne üretir?
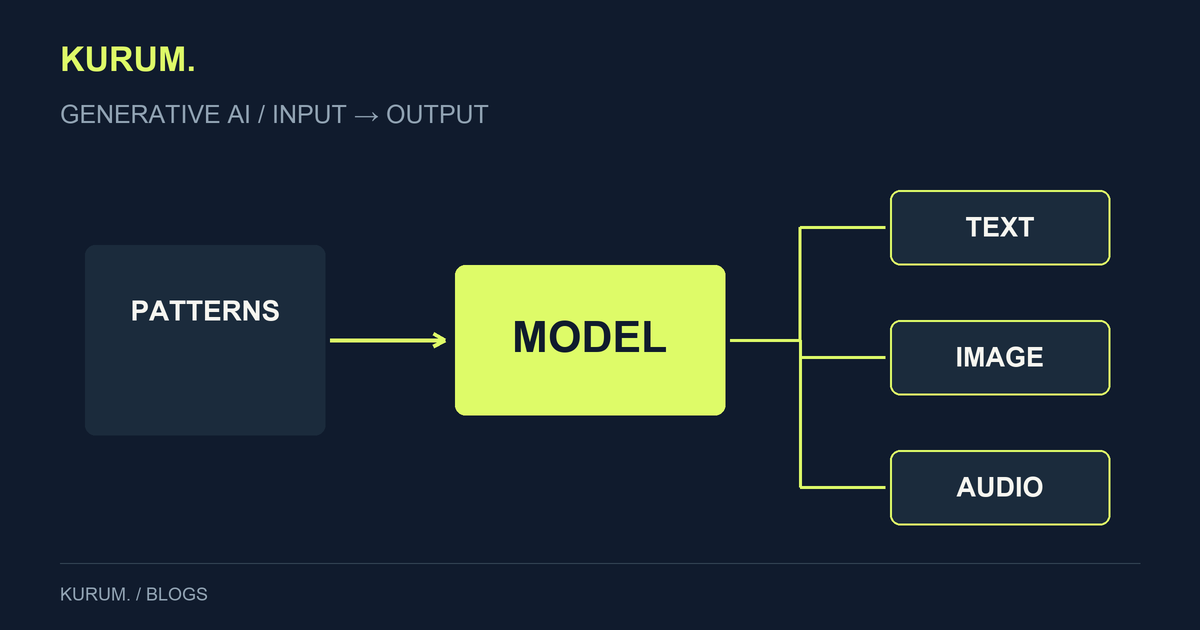
NIST’in tanımı metin, görüntü, video ve ses gibi sentetik içerikleri kapsar. Geleneksel bir sınıflandırıcı bir e-postayı belirli bir gruba yerleştirebilir; üretken bir araç ise o e-postaya yanıt taslağı hazırlayabilir. Birincisi seçilmiş kategoriler arasında karar verirken ikincisi çıktı oluşturur. Aynı üründe iki yaklaşım birlikte kullanılabilir. [1][2]
Örneğin bir şirket gelen mesajı önce satış veya destek olarak ayırıp sonra uygun bir yanıt taslağı oluşturabilir. Bu örnek bir ürün önerisi değil, iki işlevin farkını gösteren varsayımsal bir akıştır. Okur için önemli ayrım, sistemin veri hakkında karar mı verdiği yoksa yeni bir içerik mi ürettiğidir.
Nasıl çalışır?
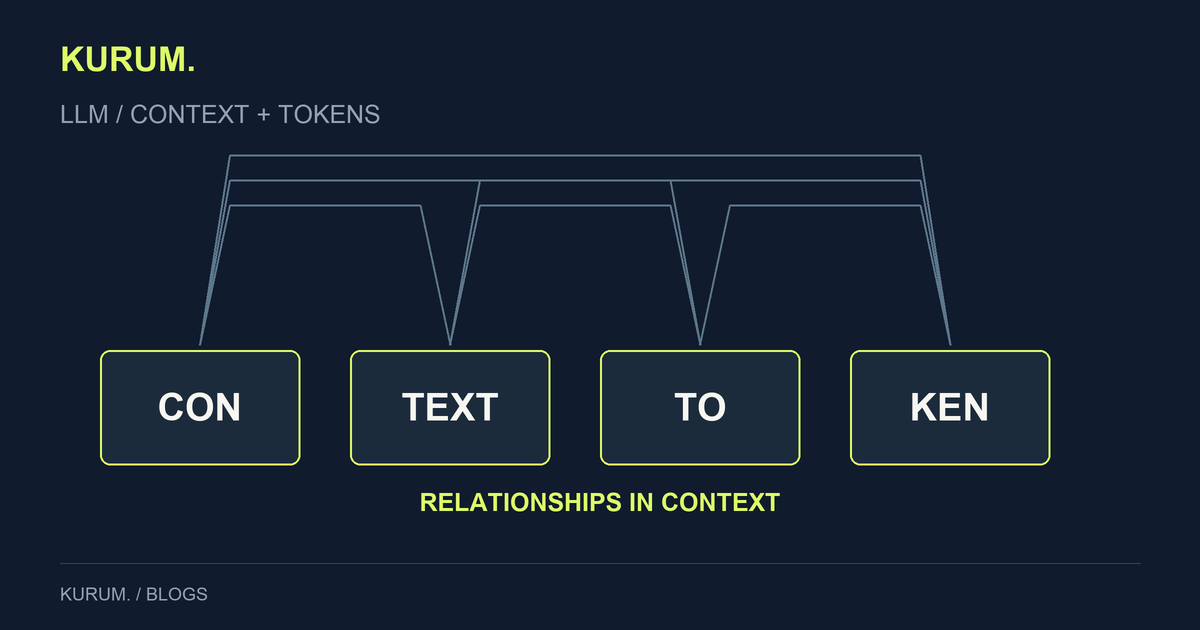
Model, eğitim sırasında verilerdeki ilişkileri öğrenir; kullanım sırasında verilen isteğe ve bağlama göre çıktı oluşturur. Bu mekanizma bir arşivdeki tek doğru cümleyi bulmakla aynı şey değildir. Kullanıcı talimatı, sağlanan belgeler ve modelin özellikleri sonucu etkiler. “Üretken” adı içerik oluşturma işlevini anlatır, bütün yapay zekâ türlerini kapsamaz. [2]
Bir satış metni taslağı için ürünün özelliklerini vermek ile yalnızca “iyi bir metin yaz” demek farklı başlangıçlardır. İlkinde doğrulanabilir bir çerçeve vardır. İkincisinde araç boşlukları kendi ürettiği ifadelerle doldurabilir. Bu yüzden iyi kullanım, yalnızca etkileyici bir komut yazmaktan çok, doğru girdiyi ve kontrol adımını tasarlamaktır.
İş dünyasında nerede işe yarayabilir?
İlk taslak, uzun bir belgeden konu başlıkları çıkarma, farklı anlatım seçenekleri hazırlama ve yazılım geliştirme desteği olası kullanım alanlarıdır. Bunlar garantili verimlilik oranları değildir. İşin doğruluk ihtiyacı, kontrol süresi ve hatanın maliyeti sonucu değiştirir. Daha hızlı yazılan ama daha uzun düzeltilen bir metin her zaman tasarruf sağlamaz.
Küçük bir deneme için tek bir görev seçin. Örneğin aynı on anonim destek sorusuna insanın hazırladığı yanıtlarla aracın taslaklarını karşılaştırın. Değerlendirme başlıkları doğruluk, eksik bilgi, üslup ve düzeltme süresi olabilir. Bu on örnek genelleme için yeterli istatistik oluşturmaz; yalnızca ilk sorunları görünür kılan bir pilot tasarımıdır.
Kullanımdan önce hangi sorular sorulmalı?
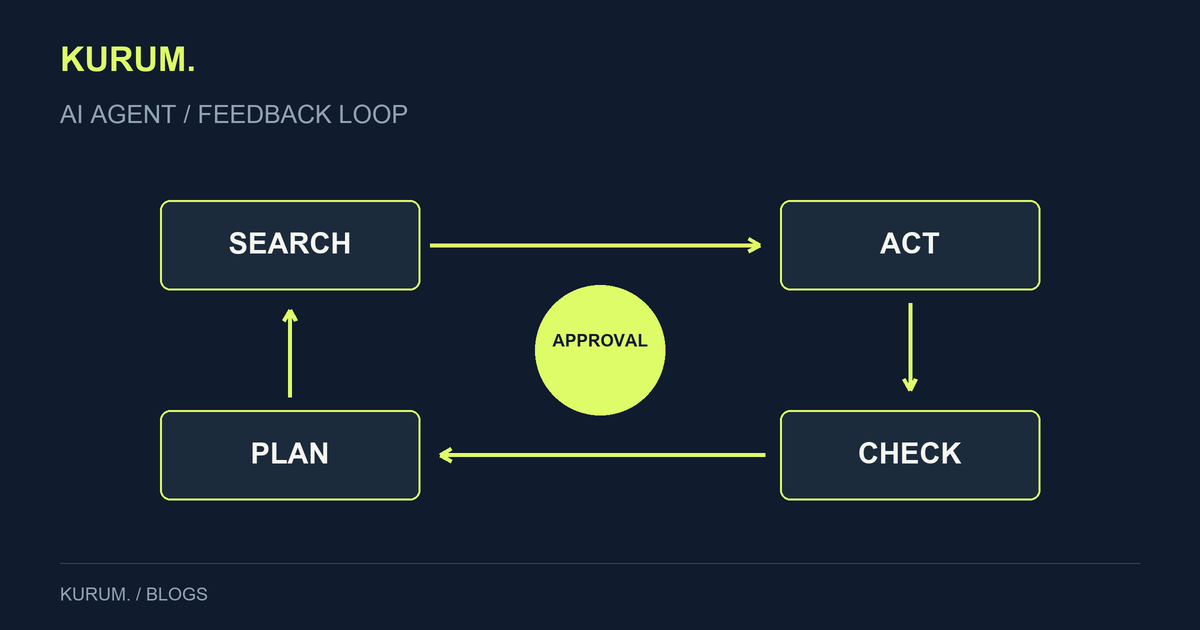
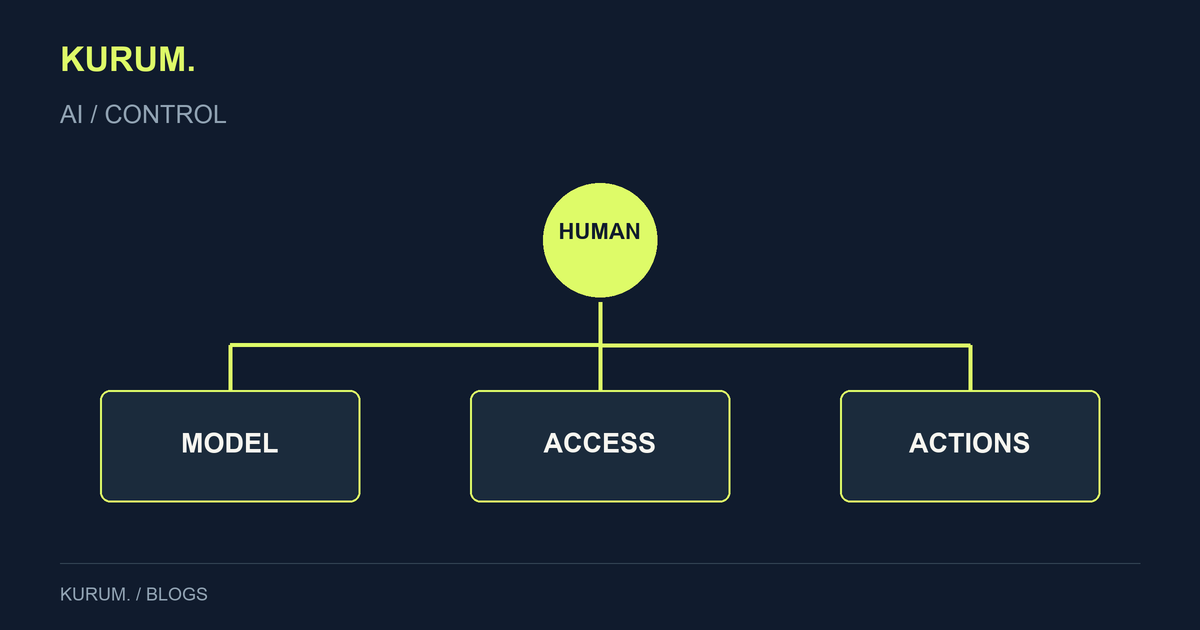
NIST’in risk çerçevesi, güvenilirlik konusunu ürünün tasarımından kullanımına kadar ele alır. KURUM.’un önerdiği kontrol, görev ve veri üzerinden başlar: Hangi bilgi giriliyor, kim erişiyor, çıktı nerede kullanılacak? Hassas müşteri verisiyle kamuya açık ürün açıklaması aynı işlem gibi görülmemelidir. [3]
- Kaynağı olmayan sayı ve alıntıları doğrulayın.
- Verilen belgenin güncel ve doğru sürüm olduğundan emin olun.
- Ürün iddialarını şirketin onaylı bilgileriyle karşılaştırın.
- İçeriği yayımlayacak veya kullanacak sorumluyu belirleyin.
Üretken yapay zekâ ile LLM aynı mı?
Hayır. Üretken yapay zekâ daha geniş bir içerik üretme alanını anlatır; büyük dil modelleri ise dil üzerinde çalışan model ailesidir. Bir ürünün sohbet arayüzü, bilgi araması ve görsel üretimi birleştirmesi bu parçaların tek bir işlev olduğu anlamına gelmez. Ayrımı bilmek, araçtan ne bekleneceğini daha açık tanımlamayı sağlar.
İşe başlamak için bütün şirkete tek seferde yaymak gerekmez. Tek bir görev, güvenli bir veri kümesi ve açık bir başarı ölçütü daha değerlidir. Sonuca bakarken yalnızca üretim hızını değil, çıktının gerçekten kullanılabilir hâle gelmesi için harcanan toplam emeği ölçün.
Sık sorulan sorular
Her yapay zekâ üretken midir?
Hayır. Bazı sistemler sınıflandırır veya tahmin yapar; üretken sistemler içerik oluşturur.
Çıktı doğrudan yayımlanabilir mi?
Göreve göre olgu, hak, veri ve üslup kontrolü gerekir. Akıcı görünmesi yayıma hazır olduğu anlamına gelmez.
Şirketler başarıyı nasıl ölçmeli?
Belirli bir görev için doğruluk, düzeltme süresi ve kullanılabilir çıktı oranını mevcut süreçle karşılaştırabilir.
Kaynaklar
Kaynak kontrolü: 29 Ekim 2026